다섯 달 동안, 판매 중인 상품 페이지 다섯 개 중 하나가 조용히 Google 검색 결과에서 빠져 있었다. 원인은 검색 로봇에게 무엇을 읽어도 되는지 알려 주는 파일의 한 줄 변경이었다.
바로 이런 일을 잡으라고 둔 감시 프로그램이 있었다. 검색 데이터를 계속 모으고, AI가 쓴 요약을 하루 두 번 Slack에 보냈다. 그런데도 못 잡았다. 자세히 들여다보니 더 나빴다. 그 감시는 몇 달 전부터 사이트맵을 보고 있지 않았고, 그 흔적은 하루 한 줄짜리 로그뿐이었다. 깨진 사이트맵 URL 수천 개가 수집만 되고 진단되지 않았다. 경보는 있었지만 맡는 사람이 없었다. 게다가 대수롭지 않은 변경에도 경고가 떠서, 경고는 이미 아무 의미가 없어진 뒤였다.
그 감시 프로그램이 LLM과 일하는 데 가장 쓸모 있는 규칙을 가르쳐 줬다. 이 글의 주제다. 판정은 코드가 하고, 설명은 모델이 한다.
내 일에 AI 에이전트를 들이면서 배운 것을 정리하는 시리즈의 2편이다. 1편은 내 일이 어떻게 바뀌었는지에 관한 글이었다.
두 종류의 답
어떤 도구는 결정론적이다. 같은 입력이면 언제나 같은 결과가 나온다. 스프레드시트 수식, 정산 계산, 데이터베이스 쿼리가 그렇다. 백 번 돌려도 백 번 같은 답이 나오고, 틀릴 때도 늘 같은 방식으로 틀리니 찾아서 고칠 수 있다.
LLM은 확률적이다. 지금까지 본 것 다음에 올 가장 그럴듯한 말을 이어 쓴다. 그래서 같은 질문에 다른 답이, 때로는 다른 결론이 나온다. 초안, 요약, 번역, 분류를 그렇게 잘하는 이유이고, 숫자를 자신 있게 틀리는 이유이기도 하다.
그래서 일을 이 선으로 나눈다.
| 결정론적 코드 | LLM | |
|---|---|---|
| 다시 물으면 | 같은 답 | 다른 답일 수도 |
| 잘하는 일 | 합계, 임계값, 상태, 규칙 | 초안, 요약, 진단, 설명 |
| 틀릴 때 | 늘 같은 방식이라 시험하고 고칠 수 있음 | 가끔, 예고 없이, 그럴듯하게 |
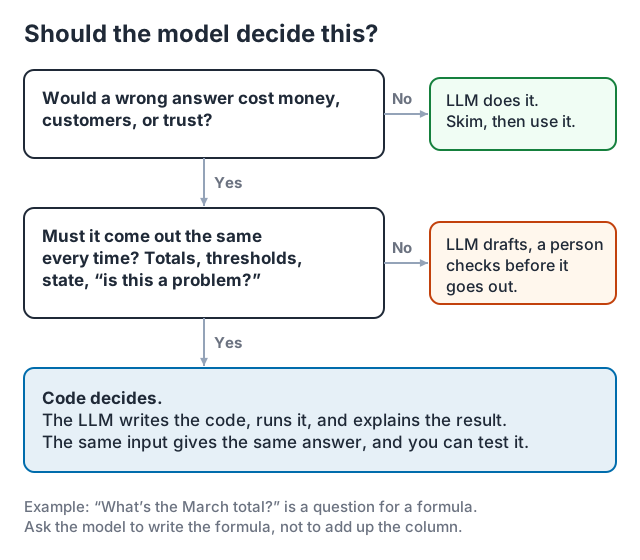
일상적인 예를 들면 이렇다. 모델에게 “3월 합계가 얼마야?”라고 묻지 말고 그 합계를 구하는 수식을 써 달라고 한다. 계산은 수식이 하고, 모델은 그 수식을 만들고 결과를 설명한다.
그냥 모델이 데이터를 보고 판단하면 안 될까?
솔깃하다. 매일 아침 에이전트에게 대시보드를 보여 주고 “이상한 거 있어?”라고 물으면 된다. 실제로 그렇게 할까 고민했고, 왜 안 되는지를 적어 뒀다.
- 같은 데이터에 다른 판단이 나올 수 있고, 빠뜨린 판단은 아무 신호도 남기지 않는다. 모델도 과거 사례로 평가할 수는 있다. 다만 매번 같은 판정을 내리리라고 기댈 수는 없다. 화요일에 괜찮다던 급증이 수요일에는 문제가 될 수 있다. 그리고 모델이 무언가를 그냥 언급하지 않으면, 그게 빠졌다는 걸 알려 주는 것이 없다. 이 점검들에는 매번 같은 답을 내는 명시적인 규칙이 필요했다.
- 모델이 멈추면 경보도 멈춘다. API 장애, 호출 한도, 바닥난 크레딧(실제로 겪었다. 3편에 쓴다). 모델을 거쳐 가는 경보 경로는 이 모든 실패를 그대로 물려받는다.
- 비용과 부하를 예측할 수 없다. 모델이 매번 무엇을 조회할지 정하면, 얼마나 읽을지, 얼마가 들지 미리 말할 수 없다.
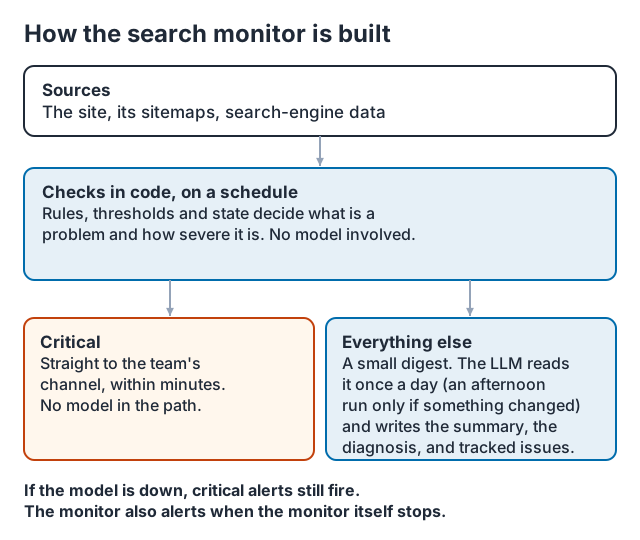
그래서 다시 만든 감시 체계 세 개 모두 판정은 코드가 한다. 모델을 쓰는 곳에서는 모델이 그 결과를 읽고 설명한다. 전체 모양은 검색 감시가 잘 보여 준다.
감시 1: 검색 노출, 하루 만에 다시 만들다
새 검색 감시는 이렇게 돈다.
- 심각도는 코드가 정한다. 문제 종류마다 건수, 심각도, 상태(새로 생김, 나빠짐, 해소, 재발)를 작은 데이터베이스에 남긴다. 심각도가 곧 전달 경로다.
- 긴급은 10분 안에 바로 채널로 간다. 그 경로에 모델은 없다. 우리가 이미 겪었던 문제들이 여기에 들어간다. 검색 로봇 규칙 파일의 변경, 등록되지 않은 사이트맵, 수집 중단.
- 감시가 자기 자신도 감시한다. 수집이 멈추거나 일일 보고가 오지 않으면 그것도 긴급 경보다. 원래 문제가 반쯤 죽은 감시였으니까.
- 나머지는 하루 한 번 모델이 맡는다. 결과를 읽고, 문제 묶음마다 진단하고, 원인마다 추적 이슈를 만들고, 요약을 올린다. 오후 점검은 아침 이후 바뀐 게 있을 때만 모델을 깨운다. 바뀐 게 없으면 모델 호출도 없다.
코딩 에이전트와 함께 설계부터 배포까지 하루에 끝냈다. 첫 실행에서 아무도 몰랐던 문제를 찾아냈다. 검색 엔진에게 404가 나는 URL을 가리키고 있던 페이지 묶음이었다.
감시 2: 가격 점검, 다시 확인한 뒤 알린다
또 다른 점검은 가격 비교 사이트에 보내는 피드의 가격과 우리 상품 페이지의 가격을 비교했다. 돌 때마다 메시지를 보내서 하루 30건쯤이었고, 매일 아침 오경보를 냈다. 피드는 하루 몇 번, 그 시점의 환율로 다시 만들어지는데 우리 페이지는 바로 바뀐다. 그래서 매일 아침 몇 시간 동안은 외화 상품 대부분이 같은 작은 비율로 피드와 어긋난다.
영리한 해결책은 뻔해 보였다. 한 통화의 모든 상품이 같은 비율로 어긋나면 환율 시차이니 무시한다. 기록된 실행 400회로 이 규칙을 되돌려 시험했다. 오경보가 97건 나왔다. 상품마다 비율이 조금씩 달랐고, 환율을 아예 따라가지 않는 상품도 있었다.
실제로 배포한 건 지루한 해결책이었고, 하루 만에 다시 만들었다. 작은 상태 기계다. 가격이 어긋나면 바로 알리지 않고 기억해 둔다. 다음 피드가 만들어진 뒤 그 상품을 다시 본다. 여전히 틀리면 알린다. 맞으면 조용히 닫는다.
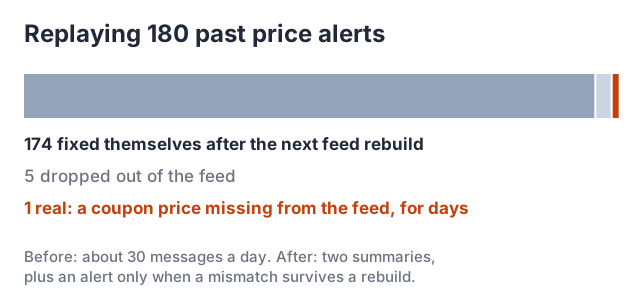
지난 경보 180건을 이 규칙으로 다시 돌려 봤다. 174건은 다음 피드에서 저절로 맞춰졌고, 5건은 피드에서 빠진 상품이었고, 실제 문제는 한 건이었다. 쿠폰가가 며칠째 피드에서 빠져 있던 문제다. 상태 기계가 이 한 건을 일시적인 불일치들과 갈라냈다. 이제는 다음 피드가 만들어진 뒤에도 불일치가 남을 때만 경보를 보내고, 별도로 하루 두 번 요약한다. 이 점검에는 모델을 아예 쓰지 않는다. 필요해질 때까지 붙이지 않기로 했다.
대가도 적어 뒀다. 진짜 가격 문제는 이제 다음 피드가 만들어진 뒤에야 드러난다. 낮에는 몇 시간, 밤에는 최대 반나절까지 늦다. 이 점검에서는 그게 조용함의 값으로 맞다.
감시 3: 운영, 규칙 엔진과 하루 한 번 읽는 모델
사흘 동안 같은 운영 점검을 손으로 세 번 돌렸는데, 매번 새 문제가 나왔다. 그중 하나는 기존 경보 수십 개가 놓친 12분짜리 데이터베이스 포화였다. 포화 상태가 더 오래 지속돼야 경보가 울리도록 설정돼 있었다.
그래서 이틀쯤 걸려 규칙 엔진을 만들었다. 규칙 40개와 테스트 48개, 실제 데이터로 만든 “기준일” 사흘치(사고가 있던 날 둘, 조용한 날 하나)가 바탕이다. 30분마다 돌고, 모델은 끼지 않는다. 설계상 하루 한 번 모델이 결과를 담은 30KB 이하의 작은 요약본을 읽고 요약과 이슈를 쓴다.
두 가지 검증을 거쳐 그림자 운영으로 계속 시험할 근거를 얻었다.
- 믿기 전에 재생한다. 일주일치 실제 로그로 돌려 보며, 중간 등급 경보가 하루 두 건 이하가 되고 사고가 없던 날의 높은 등급 경보가 모두 실제 사건이 될 때까지 맞췄다.
- 먼저 그림자 운영을 한다. 지금도 아무도 호출하지 않고 결과만 쌓는다. 벌써 효과를 봤다. 12.4분 간격으로 일어난 서버 재시작 두 번을 사고로 표시했는데, “배포로 보는” 간격이 10분이었기 때문이다. 누구를 깨우기 전에 새 테스트와 함께 고쳤다.
정직하게 말하면 이 감시는 아직 실제 운영 사고를 잡은 적이 없다. 측정한 비용 수치는 하나다. 캐시를 넣어 실행당 로그 스캔량을 이전의 약 5분의 1로 줄였다.
여기서 얻은 것
- 판정은 반복되는 곳에 둔다. 모델도 평가할 수는 있다. 하지만 매번 같은 답을 내고, 지난주 데이터로 다시 돌려 그걸 증명할 수 있는 건 코드로 된 규칙뿐이다.
- 규칙을 믿기 전에 재생한다. 영리한 휴리스틱은 종이 위에서는 그럴듯했다. 실제 실행 기록으로 재생해 보니 배포 전에 오경보 97건이 드러났다.
- 긴급 경로에서 모델을 뺀다. 모델이나 API나 크레딧이 멈춰도 긴급 경보는 울려야 한다.
- 추가 모델 호출은 변화가 있을 때만 한다. 검색 감시의 오후 점검은 아침 이후 달라진 게 없으면 모델을 호출하지 않는다.
- 감시하는 것을 감시한다. 조용히 멈춘 감시는 없는 것보다 나쁘다. 지켜지고 있다고 믿게 만들기 때문이다.
- 조용함을 설계한다. 주인 없는 경보는 모두에게 경보를 무시하는 법을 가르친다. 모든 경보는 “누군가 움직여야 한다”는 뜻이어야 한다.
여기서도 모델은 많은 일을 한다. 코드 대부분을 썼고, 매일 결과를 읽고, 사람들이 실제로 읽는 설명을 쓴다. 다만 무엇이 잘못됐는지에 대한 최종 판정만은 모델에게 주지 않는다.
시리즈 목차
- 직접 하던 사람에서 맡기는 사람으로
- 판정은 코드가, 설명은 LLM이 (이 글)
- 내가 절대 어기지 않는 규칙
- 맥락이 실력이다
- 에이전트는 잊는다, 그래서 적는다
- kenny: 내 일을 대신하는 에이전트
- Hermes: 확인할 일을 챙겨 주는 리마인더
- 2주 만에 시작하는 법
여러분의 시스템에서, 코드 몇 줄로 판정하고 시험할 수 있는 일을 모델이 대신 판단하고 있는 곳은 어디인가?